0. 生成模型
0.0 一些概念
0.0.1 散度
- 可以理解成:一个位置附近,粒子群是在“膨胀”还是“收缩”,它不是速度本身,也不是速度对时间的变化,而是速度场在空间上的局部发散程度。
- 用一维的例子:
- 散度 = 速度场导致局部体积膨胀/压缩的瞬时速率
0.1 概述
![[1_generative_model.png]]
- 输入:
- 一个简单分布,比如N(0,1)
- 可选条件,比如你要生成“猫”,“猫”就是条件
- 输出:一个复杂分布,比如所有动物的图片组成了一个复杂分布。
- 目标:希望模型映射出来的复杂分布跟真实的复杂分布越相似越好。
- 分布映射:生成模型将一个简单分布中的采样点映射到复杂分布中的一个点,你难以从复杂分布中采样出来一个合理的动物图片,但是你可以从简单分布中随机采样一个点。
0.2 似然函数
1)举例
-
假设你有一枚可能有偏的硬币,抛了 10 次,结果是:7 次正面,3 次反面。 你想知道这种硬币正面朝上的概率是多少?
-
直觉:根据观测结果,正面朝上的概率应该是70%。
-
似然函数:
- 用一个参数
- 你观测到的结果是7正3反。假设每次抛硬币是独立的,那么模型认为恰好观测到这一串结果的概率是
在固定观测数据的前提下,把「数据出现的概率」看成参数
- 用一个参数
-
极大似然估计:
- 我们的目标是想知道硬币正面朝上的概率是多少,也就是
- 因此问题变成了:找到一个
- 对似然函数求导:
- 解方程:
- 我们的目标是想知道硬币正面朝上的概率是多少,也就是
-
推广到生成模型
- 观测数据:训练集
- 参数: 模型
- 假设训练集图片都是从真实图像分布
- 极大似然估计:找到一个
- 实际训练过程中,由于似然函数通常是连乘,容易导致数值下溢,因此通常取对数,变成:
- 观测数据:训练集
-
更具体的例子:
- 假设一个生成任务,你要生成猫、狗、鸟这三张图。你经过训练后假设训练了两个模型:
- 你的训练数据(观测数据)是
- 下面进行极大似然估计,其似然函数是:
- 带入模型1:
- 带入模型2:
- 模型1的似然函数概率更大,因此模型1更好
- 假设一个生成任务,你要生成猫、狗、鸟这三张图。你经过训练后假设训练了两个模型:
0.2 GAN
![[2_gan.png]]
- 模型:
- generator:
- 输入:随机变量(简单分布随机采样值)
- 输出:目标分布采样结果(比如你想要的图片)
- discriminator:
- 输入:generator生成的样本
- 输出:分数
- generator:
- 流程:
- 初始化模型,准备GT数据、
- generator生成fake1
- 随机采样fake1或GT输入discriminator得到score1
- fake数据应该给低分,GT数据应该给高分,优化discriminator
- 固定discriminator,generator生成fake2
- 随机采样fake2或GT输入discriminator得到score2
- fake数据应该给高分,优化generator
- 循环,最终预期generator能够欺骗discriminator
- 损失函数:
- 训练discriminator时:
- 训练generator时:
- 训练discriminator时:
- 实际训练过程中,GAN通常难以拟合,通常一开始的时候由于生成的图片很容易区分,所以判别器很容易训练的很好,导致loss的第二项=0,然后生成器训练的时候梯度更新就会出错。
0.2.1 为什么要用判别器(discriminator)
生成模型的目的是为了让生成的分布接近你想要的真实分布,为什么不直接衡量两个分布的相似度呢?(衡量两个分布的相似度可以用散度来计算)
- 散度通常无法求导,不好做优化,因此损失函数通常不使用散度。GAN的做法是引入判别器,判别器是一个分类器,分类器的损失函数通常是交叉熵损失函数。当判别器取得最优解的时候,可以证明loss与js散度是等价的。
0.2.2 GAN的一些问题
1) Wasserstein Distance
- js散度不好,因为通常生成分布和真实分布重叠很小,刚开始训练的时候很可能完全没有重叠,对于js散度,两个没有重叠的分布得到的值是一样的,不利于更新。如果采样不够多,即使两个分布重合很多,我们通过采样结果也看不出来。
- 待补充###
2) Model Collapse
- 生成的图片集中在一个很小的分布内,生成器发现了判别器的一个bug,就一直生成这几张图
3)Model Dropping
- 输出分布是真实分布的一部分,比如只能生成训练集数据,难以生成新数据
- 解决:
- 增加训练数据量
- 使用更复杂的模型
- 使用更复杂的损失函数
- 使用更复杂的优化器
- 使用更复杂的采样方法
- 使用更复杂的评估指标
- 使用更复杂的评估指标
4) 如何评估生成的多样性
- 将所有的生成结果输入分类器,将得到的分布(因为分类器单词输出的是每个类别的概率)加起来。加起来的分布越平均,说明多样性越高。
0.2.3 Conditional GAN
1)Cycle GAN
![[3_cyclegan.png]]
- 以风格迁移为例,Cycle GAN需要两个生成器,G1将图片转换风格,G2将风格还原,还原后的图片与原图越像越好。判别器经过训练之后可以分辨风格,将生成的图片输入判别器打分。
- 如果不要G2, 生成的图片可能与原图无关。但实际情况下不要G2也能train起来。
0.3 VAE
0.3.1 Auto Encoder
![[4_ae.png]]
-
概括:将高维数据压缩为低维向量,然后还原。高维数据存在冗余信息,所以可以压缩。
-
模型:
- encoder:将高维数据压缩为低维向量
- decoder:将低维向量还原为高维数据
-
损失函数:
- 重构损失:
- 正则损失:
- 重构损失:
-
训练:
- 随机采样一个样本x,经过encoder得到z,经过decoder得到x',计算x和x'的差距,优化encoder和decoder。
- 随机采样一个噪声z,经过decoder得到x',x'再经过encoder得到z',计算z和z'的差距,优化encoder和decoder。
-
应用:
- 数据降维
- 图像压缩
- 异常检测
- 数据去噪:输入加噪图片,输出去噪后的图片,训练跟真实GT差距
- 特征解耦:encoder得到code之后,取code中的某些维度,可以得到某些特征,比如人脸的眼睛、鼻子、嘴巴等。例如将code编码成长度为n的向量,每个维度为0或1,代表有无某个特征
0.3.2 Variational Auto Encoder
![[6_vae.png]]
-
AE的latent空间不规则,容易过拟合,且是一对一映射。VAE的encoder输出向量拆分成均值和标准差,然后N(0,1)采样得到latent,应用均值标准差之后变成高斯分布中的一个点。encoder相当于将输入映射到高斯分布中的一个点。然后decoder将latent还原为原始数据。
-
VAE的latent空间更规则,他就可以有更多的规律,比如可以做特征插值,code1表示圆月,code2表示弦月,中间插值的code在vae中可以得到半月,而AE无法控制。因为VEA将一个输入编码为一个分布(一对多),更容易采样。中间部分为了最小化均方误差会得到既像满月又像弦月的图片。
-
损失函数:
- 重构损失:让decoder尽量还原原图
- KL散度损失:训练的时候他为了最小化重构误差,很可能让
-
损失函数推导
- 待补充###
VQVAE
![[5_vqvae.png]]
- 增加一个codebook,codebook中的每个元素是一个向量,向量长度为k,向量个数为n。codebook也是学习出来的。
1)训练:
- 随机采样一张真实图像
- encoder 输出连续 latent
- 向量量化(Vector Quantization):对
- decoder 用
- 计算总损失并反向传播,更新 encoder、decoder、codebook
- 重复以上步骤
2)损失函数(三部分):
- 重构损失:让 decoder 尽量还原原图,训练 encoder + decoder
- codebook 损失:让 codebook 里的向量
- commitment 损失:让 encoder 输出
-
3)优势
- VQ-VAE相当于在VAE的基础上,将Encoder的输出从原来连续的Latent向量变为离散型的编码,通过向量量化,预定义一个可学习的码本(Codebook),包含一组离散向量。编码器的输出被替换为码本中最近的向量,从而离散化。先验分布不再固定(不强制要求比如接近正态分布),而是通过训练学习。
- 相比于连续空间,离散空间的优势有:1、在许多任务中,其需要有意义的隐变量表征,需要隐空间仅保留重要特征,而离散变量更契合这一点;2、连续隐变量存在训练困难以及后验坍塌风险高(即Encoder无效了)的问题。
0.4 Flow
0.4.1 推导过程
- 生成模型的目标:最大化对数似然:
- 当样本数量足够多时,经验平均可以近似真实数据分布下的期望(简单理解,将上面的式子除以m):
- 写成积分形式:
- 写成KL散度形式(这里取反,相当于转换成loss形式):
- 其中:
只和真实数据分布有关,和模型参数
-
在VAE中,优化目标是他的一个下界,而flow模型直接优化似然函数。对于图像这种高维数据,直接建模:
-
Flow 的核心思想:把复杂分布变成简单分布。 Flow 不直接建模复杂的图像分布,而是学习一个可逆变换:
反过来:
其中
- 变量替换公式:因为
则可以用变量替换公式计算
代入极大似然目标得到:
- 要优化上面的目标要求知道:
- 反函数:
- 反函数的雅可比矩阵:
- 反函数:
- 训练过程中你只知道网络模型:
Flow 是一种通过可逆变换,把复杂数据分布映射到简单高斯分布,并且可以精确计算似然的生成模型。
0.4.2 常用设计
1)Coupling Layer
![[7_coupling_layer.png]]
-
可逆计算
- 正向(黑线):输入z得到x
- 输入Z拆为两组,第一组直接copy得到x1到 xd。
- 同时第一组z通过两个函数(网络)分别得到
- 第二组z乘以
- 反向(红线):输入x得到z
- 根据第一组x得到第一组z,然后根据z又可以得到
- 一部分x减去
- 根据第一组x得到第一组z,然后根据z又可以得到
- 正向(黑线):输入z得到x
-
雅可比计算 ![[8_jacobin.png]]
-
这种方案将多个couping layer叠加的时候要换个方向,防止第一部分输入一直不变。
2)1*1卷积
![[9_cov.png]]
- 每个像素点乘以一个3*3矩阵可以交换通道。
- W作为generator,要求可逆
0.5 Diffusion
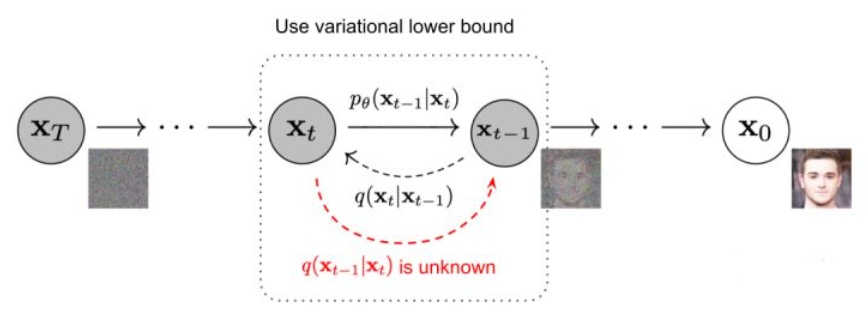
- DIffusion受郎之万动力学启发,定义两条马尔可夫链:
- 前向过程:逐渐向数据添加高斯噪声
- 反向过程:学习与前向过程对应的逆扩散过程,从噪声中还原数据样本。从其推导过程,diffusion可以看成一种多层的VAE,不过其隐变量具有与原始数据相同的高维度。
0.5.1 前向过程
- 前向过程不需要训练,这是一个预先定义的过程,前向过程分为T步(1000)。
- 初始有一张真实图片
- 对
- 对
- ...最终得到
- 当步数T足够长时,原始
- 整个过程表达为:
0.5.2 反向过程
- 假设你有一个网络可以精准预测出你每一步加入的噪声,你就可以还原出来原始图片。
- 从简单高斯分布采样一个噪声
- 将
- 将
- ...最终得到图片
- 整个过程表达为:
0.5.3 训练过程
- 从数据集取一张真实图片
- 根据前向公式计算出需要注入的噪声
- 用这个噪声加噪图片得到
- 将
- 计算损失
0.6 FLow Matching
- 与diffusion一样,也是将已知分布一步步转化为真实图片分布。假设t=0时刻是已知的简单分布,t=1时刻演变成真实分布。
0.6.1 流的概念
1)轨迹
- 一个点在不同时刻的位置:
2)向量场/速度场
- 空间中每一个位置在每一时刻的速度:
- 向量场定义了运动规则
3)流
- 一系列轨迹的集合,每个轨迹都按照向量场
- 流和向量场是一一对应的,确定了流的公式就确定了向量场的公式,反之亦然。
- 流表达的是一个轨迹而不是一个分布。
0.6.2 Flow Matching流程
- 用神经网络来学习一个向量场
- 从已知分布
- 对x0,应用网络学习到的向量场,运动到x1
- 从x0到x1形成一条轨迹。遍历初始分布形成很多条轨迹,也就是一个流。
- 这个流初始点满足
- 推理过程: 神经网络学习到了向量场u,推理步数为n
- 设置t=0
- 设置时间间隔(h=1/n)(这段时间内匀速)
- 采样x0
- for i=1, .... n-1:
-
$x_{t+h}=x_t+h\cdot u(x_t)$ -
t=t+h - end for
- return
1. Diffusion基础
1.2 DDPM
1.2.1 马尔科夫链
- 马尔可夫链(Markov chain)是一种随机过程,其特点是“无记忆性”,即未来状态的概率仅依赖于当前状态,而与过去的状态无关。(单链表)
1.2.2 前向加噪
- 定义一个马尔可夫加噪过程,对当前状态(已知
- 假设
- 假设
- 因此
- 你可以把这个分布理解为一个函数,你给他输入一个
- 前向过程决定了,根据当前状态,下一步生成的状态服从什么分布
- 假设
- 整个前向过程可以定义为:
- 假设你带入固定值:
- 假设你带入固定值:
- 由于马尔可夫假设,我们可以将前向过程进一步定义为:
- 单步加噪:
- 对于单步转移
- 希望下一步在保留一部分
- 由于
- 从整个边缘分布来看,为了使前向扩散过程中数值尺度保持稳定,DDPM以单位方差作为参考尺度,即
- 因此:
- 定义本步加入噪声的方差为
- 最终得到:
- 对于单步转移
- 公式累积可以直接得到多步加噪:
1.2.3 反向推理
- 定义单步反向过程:
- 反向过程的一个重要理论依据是:前向单步是“小幅高斯扰动”,当每一步的
- 如何计算
- 应用极大似然估计:
-
- 假设有联合分布
- 假设有联合分布
-
- 根据期望的定义,可以写成:
-
- 利用jensen不等式:
- 最大化 ELBO 等价于最小化负 ELBO:
-
- 损失分析:
- loss里面的两项概率分别带入整个前向过程和反向过程的定义:
- 单独把 t=1 的项拿出来(这一项最终对应直接从 x1 恢复真实数据 x0 的重建项。):
- 利用贝叶斯公式:
- 这一步非常关键:原来 Loss 里面出现的是前向分布
- 这一步非常关键:原来 Loss 里面出现的是前向分布
- 整理后的式子带入中间项的分母,进行连续消除:
- 分别处理这三项
- 第一项:
- 第二项:先抛开求和符号,取一个固定的t:
- 第三项:
- 第一项:
- 最终loss整理成:
- 第一项只由固定的前向过程
- 第三项只处理
- 真正决定每一个中间反向步骤如何学习的是第二项,因此下面重点分析:
- 第一项只由固定的前向过程
- loss里面的两项概率分别带入整个前向过程和反向过程的定义:
- 计算训练时真实后验
- 前面已经通过贝叶斯公式得到:
- 分子的两项已知,分别是前向单步和前向多步:
- 分母
- 右边是两个关于
- 将单步前向写成指数形式:
- 将多步前向写成指数形式:
- 两项相乘:
- 步骤 4) 推理出
- 整理 7) 之后得到:
-
- 高斯分布的指数形式:
- 将 8) 整理成高斯分布的形式:
- 最终得到
- 方差:
- 均值:
- 带入多步前向公式替换
- 带入多步前向公式替换
- 方差:
- 前面已经通过贝叶斯公式得到:
- 计算loss第二项的KL散度:
- 左侧这个高斯分布我们已经算出来均值方差,右侧是我们用神经网络模拟的分布。理论上当这个神经网络模拟的分布
- 两个高斯的KL散度可以写出来:
-
- 采用DDPM的方法固定
- 如果进一步,用
- 左侧这个高斯分布我们已经算出来均值方差,右侧是我们用神经网络模拟的分布。理论上当这个神经网络模拟的分布
- 第三项:
- 反向分布定义成高斯分布:
- 写出他的概率密度公式,带入x0:
- 要取最小值,只需要
- 反向分布定义成高斯分布:
- 综上,我们可以训练一个网络,这个网络输入
- 最终单步反向过程:
1.2.4 训练
- 从数据集中采样真实样本
- 随机采样时间步:
- 随机采样噪声:
- 直接构造:
- 将
- 最小化噪声预测误差:
- 反向传播更新参数
1.3 DDIM
- DDPM 需要逐步采样,推理太慢了。DDIM使用同一个DDPM训练好的噪声预测网络,在不重新训练的情况下减少推理步数。 基于推理得到的加速公式,将随机因子去除后,可以得到一条概率确定的从
1.3.1 非马尔可夫链
- DDPM的标准反向采样需要沿着大量相邻时间步逐步去噪,因此推理速度较慢。DDIM通过分析DDPM的loss推导部分发现:虽然 DDPM 最初的 ELBO 推导建立在马尔可夫前向过程上,但是经过高斯后验推导、噪声参数化以及 simplified loss 的处理后,最终训练目标可以写成
t只需要从边缘分布 - 因此,,只要重新构造一个前向联合分布 q(x1:T∣x0),并保证它的每个边缘分布 q(xt∣x0) 与 DDPM 相同,就可以继续使用完全相同的噪声预测训练目标。 如果重新构造一个非马尔可夫前向联合分布,就获得了重新设计不同时间步之间关系的自由度;在此基础上,可以进一步选取时间步子序列进行跳步采样,从而减少反向推理步数。
1.3.2 前向加噪
-
DDIM将前向加噪定义为一个非马尔可夫过程:
- 例如
- 但是同一个联合概率也可以按照另一种顺序使用链式法则分解:
- 例如
-
为了保留DDPM训练的模型,DDIM还要做如下假设:
- 每个时间步的边缘分布和DDPM保持一致:
- 这保证了可以使用ddpm的前向跳步加噪,以及可以用相同的loss
- DDIM的条件分布也要定义成高斯分布(这个分布就是ddpm中loss分析时反向过程逼近的那个分布):
- 每个时间步的边缘分布和DDPM保持一致:
-
为了同时满足如下要求:
-
-
- 这一步是ddim能够跳步采样的关键,他在这里给相邻的两个随机噪声建立了关系,这样我就可以预测出当前噪声,然后根据这个关系直接得到相邻噪声。这里的相邻不一定要从t到t-1。
-
-
将刚刚假设的
1.3.3 反向推理
- DDIM的反向推理,前面的极大似然估计推导跟DDIM一样,从5. 损失分析 这里开始分叉,在此之前我们求出了: 最大化 ELBO 等价于最小化负 ELBO:
- 这一步要带入整个前向过程和反向过程的定义。DDIM的反向过程定义还是一样的马尔可夫,但是前向的定义不一样了。
- DDPM定义的单步前向是
- DDIM并没有定义DDPM形式的单步前向加噪
- DDPM定义的单步前向是
- 继续从
-
- DDIM希望逼近上面的这个分布,显然也可以用均值预测模式,不过DDIM直接沿用噪声预测模式,将预测均值仿照
- 由于推理时x0未知,因此根据跳步加噪公式把他转换一下。这里的网络可以直接用DDPM网络,训练策略跟他一样。
- 类似DDPM,网络可以不预测方差,方差直接取定值。最终采样步骤:
- 在DDPM中,因为方差可以直接算出来,因此他不用预测,把方差设置为一个固定值就行。回到DDIM,根据我们最初建立
- 当
- 当
- 当
- 总结来说:DDPM中的
- 当
1.3.4 跳步采样
- DDPM的前向过程明确规定了相邻时间步之间的马尔可夫转移:
- DDIM抛弃了DDPM的相邻前向转移
1)DDIM为什么能跳步
- 关键在于[[生成模型笔记#1.3.2 前向加噪]]的3. 这里建立了相邻噪声之间的关系。举例
- 根据ddim保留ddpm的边缘分布现在有:
- 这里面s和t不一定是相邻的t和t-1,完全可以是t和t-10。
- ddim人为建立他们之间的关系:
- 带入:
- 令
- 因此反向推理时:
- 从t到s,根据你的人为定义决定了它跳过多少步。
- 本质上,DDPM 也支持跳步。只不过 DDPM 从一开始假设了一个相邻时间步的马尔可夫扩散链,因此一旦前向转移
2)DDIM为什么不能大幅跳步
- 既然DDPM或者DDIM都可以直接确定任意
- 关键在于DDPM的网络是被训练成预测单步的噪声的,如果你直接一步预测x0,会存在误差的放大。举例:
- 假设前向过程每一步注入的真实噪声是
- DDIM反向采样,假设当前已有
- 对于当前的
- 带入:预测的噪声和x0:
- 设当初前向扩散的时候当前
-
-
- 相减:
- 相减:
-
- 如果
1.4 Latent Diffusion
- 在Latent Diffusion Model(LDM)之前,扩散模型大多是在像素空间上进行的,这导致极其高昂的运算成本,以及当像素尺寸过大时,其显存开销往往会增大到难以承受的地步。
- LDM提出了将扩散空间从像素空间转移到潜空间(Latent Space),而这个潜空间是通过预训练好的VQVAE得到的。在这个潜空间上进行训练和推理过程,一方面能够提升生成效率,另一方面还能够避免扩散模型在图像像素上的过度训练,最终显著提升计算效率的同时显著提升了生成图像的质量(也因此成为了Stable Diffsuion v1v2版本的基底模型)。此外,LDM提出了通过交叉注意力模块来将不同模态的条件加入到扩散过程中,从而实现了生成模型的生成内容的可控性。

- 图中红色框的VQVAE,提供了像素图像与latent 向量高质量转换的功能;
- 绿色部分的扩散模型,上半部分为加噪过程,下半部分为去噪过程,在去噪过程中通过Cross-Attention引入条件;
- 灰色部分的条件机制,通过一个条件编码器,将图像、文字等等条件信息编码为特征向量,最终输入到Cross-Attention中
- 例如文本嵌入,首先将文本进行分词,然后使用CLIP 文本编码器转化为若干token的特征向量,然后将其输入至Cross-Attention中,作为KV矩阵的输入,通过Attention操作与来自UNet内部的向量Query完成交互,从而实现信息的注入。
1.5 Guidance
- DDPM 学习的是无条件反向过程:
- 通常有CG和CFG两种方法,classifier-free guidance只能提高训练过程中已存在的条件信息的控制能力;而classifier guidance应用场景更加广泛,可以在任意conditional和unconditional模型上添加所需要的条件信息,但严重依赖于分类器的性能以及对于控制引导强度超参数s的调参。
1.5.1 Classifier Guidance
- Classifier Guidance 的核心是:一个已经训练好的无条件 DDPM + 一个分类器,就可以构造条件反向分布,因此不需要重新训练 DDPM。
1)条件分布
- 对目标条件分布用贝叶斯公式:
- 分母与待采样的
- 分母与待采样的
2)沿用DDPM
- 为了能够继续使用已经训练好的 DDPM,我们希望加入条件 (y) 后,不改变原来的前向加噪过程,因此定义:
- 训练图像分布不变:
- 沿用 DDPM单步加噪:
- 训练图像分布不变:
解决分子1
- 贝叶斯:
- 分子第一项:
- 分母:
- 分子第二项由2) 可知:
- 分子第一项:
解决分子2
综合
- 综合反向过程:
- 分析三个项:
- 分母:这个分布的y和xt都是已知的,因此算常数,作为一个
normalize factor,正则化因子,让概率分布和为1。 - 分子
- 分子
- 因此:
- 分母:这个分布的y和xt都是已知的,因此算常数,作为一个
3)分类器估计
- 目前反向:
- 对DDPM项写出高斯分布(
- 对分类器项,他表达的意思是,当输入
- 两项汇总:
- 其中梯度项g,对于当前采样变量
- 其中梯度项g,对于当前采样变量
- 因此反向分布
- 当前是t+1时刻,根据DDPM得到均值,然后把这个均值代替
- 当前是t+1时刻,根据DDPM得到均值,然后把这个均值代替
4)泛用采样
- 一个问题:对于 DDIM 等采样方式,尤其确定性 DDIM 中
- 定义一个概念:分数(score),对于一个分布
- 梯度
- 梯度
- 区分分数模型与DDPM模型:
- DDPM模型是每一步从一个
- score模型核心是直接看分布
- DDPM模型是每一步从一个
- 看score模型的目标分布:
- 先算第一项,对于 DDPM 的前向边缘分布:
- 再看第二项,整个score模型的逻辑是,当前在t时刻,下一步预测t-1,所以用
- 综合两项,条件分布的 score 为:
- 类比
- 根据5. 得到的结果,可以知道DDIM中预测噪声与分数的关系:
- 因此我们定义条件采样中的噪声
- 结合 7. 的结果:
- 根据5. 得到的结果,可以知道DDIM中预测噪声与分数的关系:
- 最终结论:在DDPM网络预测的噪声后面加上一个梯度偏移项,然后用DDIM采样即可。
5) 采样算法
- [[生成模型笔记#3)分类器估计]] 对应的采样算法:

- [[生成模型笔记#4)泛用采样]] 对应的采样算法:

1.5.2 Classifier-Free Guidance
- Classifier Guidance 需要额外训练一个能够处理不同噪声等级的分类器。Classifier-Free Guidance(CFG)的核心思想是:不再使用额外分类器,而是让一个扩散模型同时学习有条件生成和无条件生成。
- CFG和CG 的本质是一致的:二者最终都是在原来的去噪方向上增加一个额外的条件引导,使采样结果向满足条件 (y) 的区域移动。只不过CFG更依赖模型的训练。
- 原本的条件扩散模型为:
- 按照普通 DDPM 的方式采样时间步、噪声并构造 (x_t),训练目标仍然是预测噪声:
- 因此同一个模型最终同时学到了:
- 为什么这两个结果可以替代 Classifier Guidance 中的分类器梯度?可以从贝叶斯公式理解,分类器项:
-
- 同理第二项分数:
-
- 反向采样时,将这个分类器梯度项带入[[生成模型笔记#5) 采样算法]] 的泛用采样过程。

- 从DDPM到classifier-free guidance的时候diffusion模型已经有了很多改变,比如这里时间采样的方式不再是离散的
1...T,变成了连续的一个随机变量
- 从DDPM到classifier-free guidance的时候diffusion模型已经有了很多改变,比如这里时间采样的方式不再是离散的
- 训练算法:

- CFG 训练时,conditional 和 unconditional 分支使用的是同一个
- 原因在于,对单个训练样本来说监督确实都是同一个
- CFG 训练时,conditional 和 unconditional 分支使用的是同一个
2. FLow Matching
- DDPM建模过程本质上是在目标数据分布到先验分布的过程中不断加噪,并对噪声预测进行建模,从高观点下看的话实际上是在求解随机微分方程SDE。DDPM 原始形式是离散马尔可夫链,它在连续时间极限下可以写成 SDE;Diffusion 也存在等价的 probability flow ODE,DDIM 就和这个确定性视角关系很近。
- Flow Matching则是由Continuous Normalizing Flow(CNF)和Neural ODE演进而来,将CNF的训练转化为对速度场的拟合。随机SDE与确定性ODE从先验分布至目标分布的示意图如下图所示(ODE是确定性轨迹,x0固定后容易反演,路径设计好时可以减少采样,SDE有随机性,x0固定仍有不同轨迹,反演更复杂,通常需要处理随机扩散过程。)

2.1 ODE
2.1.1 ODE 是什么
- 常微分方程Ordinary Differential Equation,基本形式:
2.1.2 ODE举例
- 假设:
- 更一般的假设例如:
2.1.3 实际计算 ODE
- 神经网络一般不会给你 ODE 的解析解。比如 Flow Matching给出速度场:
- 你只能不断问网络:当前
- 例如
- 因此Flow Matching 推理:
2.2 SDE
2.2.1 SDE 是什么
- Stochastic Differential Equation,随机微分方程。最典型的形式:最典型形式:
-
-
-
-
2.2.2 随机项
- 对于
2.3 ODE与SDE的区别
- 区别在于SDE最后面的随机项。
- 对于ODE:当前位置固定
- 对于SDE:当前位置固定:
- 对于ODE:当前位置固定
- 举例。假设二维平面,现在人在
- ODE:模型学习之后输出的速度场是固定的。假设模型学习到的是一条直线的速度场:
- SDE:模型除了
- ODE:模型学习之后输出的速度场是固定的。假设模型学习到的是一条直线的速度场:
2.4 用 ODE 搬运一个分布
- 前面讨论的都是针对一个点的运动,给定初始点
- 假设初始点
- 生成模型描述的是分布的变化,怎么把ODE从单个点的描述写成分布的形式呢?
2.4.1 连续性方程
- 以一维的概率密度函数为例来描述,假设当前在时间步t,对于位置x,他的概率密度为

- 假设在位置 x 附近取一个很小的区间:
- 现在所有粒子都按照速度:
- 对于区间:
- 左边
- 推广到高维空间后:
- 将右侧移到左侧后它表达的含义:概率质量不会凭空产生或消失,只会随着速度场从一个位置流向另一个位置。
- 这定义了一个分布的概率密度变化率。也就是说如果我们知道了速度场
2.5 Continuous Normalizing Flow
- 在[[生成模型笔记#0.4 Flow]] 部分的Normalizing Flow使用一个显式可逆函数:
- Continuous Normalizing Flow(CNF) 将这种离散的可逆变换改成连续时间 ODE:
- ODE 本身就是连续可逆的,因此不再需要专门设计 Coupling Layer 这样的可逆网络,可以直接使用普通神经网络参数化速度场就行了。
2.5.1 CNF 中概率密度的变化
- 将连续性方程的右侧展开:
- 前面的连续性方程是在一个固定位置 x上观察概率密度怎么变化,因此没有考虑x和t之间的导数关系。但是现在我们跟着某一个粒子
- 带入
- 两边除以
- 从 t=0 积分到 t=1:
2.5.2 CNF 的训练问题
-
CNF 虽然解决了普通 Flow 必须手工设计 Coupling Layer 等可逆结构的问题,但是最大似然训练仍然比较昂贵。
-
对于一个真实数据
- 从
- 在整个 ODE 求解过程中不断计算:
- 对这个散度继续进行时间积分
- 反向传播时还需要对整个 ODE 求解过程求梯度
- 从
-
CNF的训练跟NF的训练代价相同吗?不同。
- NF 与 CNF 都需要对多层变换反向传播。CNF 的主要额外开销并非来自“多层反向传播”本身,而是来自数值 ODE 求解所需的多次网络调用,以及沿轨迹反复计算速度场散度
- NF 与 CNF 都需要对多层变换反向传播。CNF 的主要额外开销并非来自“多层反向传播”本身,而是来自数值 ODE 求解所需的多次网络调用,以及沿轨迹反复计算速度场散度
-
所以 CNF 的问题变成了:虽然网络结构不需要专门设计成可逆形式,但是训练时仍然需要不断求解 ODE。 这导致传统 CNF 很难直接扩展到高维图像等大规模生成任务。Flow Matching 原论文明确将自己的核心贡献描述为 simulation-free training of CNFs:训练阶段不再通过 ODE simulation 间接训练速度场,而是直接回归目标速度场。
2.6 Flow Matching
2.6.1 核心思想
- CNF 最终真正需要学习的是:
- Flow Matching 提出:既然最终目标就是学习速度场,那么如果我们能够直接知道一个“正确的目标速度场”
- 因此Flow Matching loss:
- 那么关键问题是,怎么找到一个能够产生这条概率路径的目标速度场:
2.7 Conditional Flow Matching
2.7.1 子问题拆分
- 现在的问题是怎么得到这个将初始分布映射为真实分布的速度场。通常有两种方式:
- 知道速度场的具体表达式
- 知道速度场的一些采样分布(在不同的t和x下,能知道速度场具体的取值),这样就可以进行训练拟合。
- 但是这两种方式我们都不知道。能否将
- 考虑在训练过程中每一步我们通常能采样到一个真实样本
- 由此形成了一个人为定义的概率分布:
- 我们定义的条件分布满足:
-
-
-
2.7.2 条件分布与代理目标
- 根据前面的定义,对每一个
- 我们定义这条路径的分布变换由速度场
- 尝试将目标速度场转换成条件速度场看看,从连续性方程开始:
- 求出来这个期望就可以知道目标速度场,但是这个期望也不好求。但是至此,我们发现条件速度场与目标速度场存在关联,能不能用这个条件速度场作为代理目标呢?考虑如下目标:
- 假设代理目标:
- 原始目标:
- 假设代理目标:
- 验证对代理目标的优化和对原始目标的优化等价:
- 代理目标梯度下降:
- 原始目标梯度下降:
- 代理目标梯度下降:
- 最终发现代理目标的优化跟原始目标是一致的(事实上,用类似的思路,也可以证明在扩散模型SDE框架里,条件分数匹配的目标跟得分匹配的目标对于优化网络参数而言是一致的)。
2.7.3 条件速度场的形式
- 因为整体是通过速度场实现分布从初始分布慢慢演化到最终分布,我们先假设中间分布是高斯分布:
- flow map,也就是概率流里的其中一条可以表示为:
- 它表示,假设我采样了一个x0,根据flow map我要的xt,得到的xt(也就是
- 概率流有无穷多条,这个只是其中一条比较简单的,相当于高斯分布的重参数化形式;
- 它表示,假设我采样了一个x0,根据flow map我要的xt,得到的xt(也就是
- 根据ODE的定义:
- 令
- 将里面的
- 将边公式110的缘分布改成条件分布:
- 公式里面为什么有一个(z),因为这是一个条件分布,你选择不同的z作为条件,条件分布
- 事实上,前面假设边缘分布
- 公式里面为什么有一个(z),因为这是一个条件分布,你选择不同的z作为条件,条件分布
2.7.4 条件分布求解
- 前面证明了代理目标的合法性,以及写出了代理目标速度项的表达式(公式111)。这个表达式的值取决于两个因素:
- 条件z取什么值
- 确定条件z的情况下,条件分布
- 前面子问题拆分的时候讲过,我们训练的时候通常只有真实数据x1,因此很自然我们希望构造条件分布:知道我们生成的结果为x1的条件下当前xt取什么值的概率。而这个条件分布前面讨论过可以假设成高斯分布,然后高斯分布的均值方差也由我们自己假设,显然我们可以根据每一步的已知值(t, x1)来构造他的均值和方差。不妨选择如下形式:
- 由此确定了均值和方差,带入公式111:
- 这个式子在训练中还有一个未知量:x,它表达的是啥?这个u的分布表达的意思是,在t时刻,已知x1时xt服从的分布,因此这里面的x代表的就是xt,也就是
- 其中x0是从初始分布中随机采样的点。至此,代理目标里面的速度项已经求出来了。
- 这个式子在训练中还有一个未知量:x,它表达的是啥?这个u的分布表达的意思是,在t时刻,已知x1时xt服从的分布,因此这里面的x代表的就是xt,也就是
- 进一步,如果采用另一种中间分布的假设形式:
- 可以看到,这是一个固定值,即条件分布是由一个恒定的速度场推动,从初始分布或者初始采样数据点,由恒定的速度走直线到目标分布或者目标采样数据点,这个条件速度场对应的条件概率流也称为rectified flow(1-rectified flow)。,或者ICFM(conditional flow matching with independent coupling)
- 在公式114中,都假设初始分布为标准高斯分布,因此公式107里面的
- 所谓“走直线”,指的是条件概率分布,而不是我们想求的最原始的边缘分布,后续在代码部分我们可以看到,尽管拟合目标是所谓的直线,但实际边缘分布或者推动边缘分布的速度场,仍然是曲线,所以才有类似2-reflow]或者OT-CFM等工作出来,尽可能将曲线拉直;
2.7.5 训练流程
- 以最简单的 ICFM / Rectified Flow 为例,首先分别从初始分布和真实数据分布采样:
- 接下来随机采样一个时间:
- 有了这三个条件,就可以构造对于前面的直线路径(条件分布下的
- 这条条件路径的GT速度也已经知道:
- 然后把构造出来的
- 因此,Flow Matching 与传统 CNF 最大的训练差异就在这里:
- 传统 CNF:
- Flow Matching:
- Flow Matching 训练阶段完全不需要求解 ODE,也不需要计算散度、Jacobian trace 或 likelihood。
- 传统 CNF:
2.7.6 推理流程
- 训练的时候虽然不需要求解 ODE,但推理的时候仍然需要求解 ODE。首先从初始分布采一个噪声:
- 然后使用训练好的速度场:
- 例如使用最简单的 Euler 方法,把 [0,1] 分成 N 步:
- 不断更新:
- 最终得到的
- 因此 Flow Matching 相对于传统 CNF有一个很重要的区别: 训练阶段不求 ODE,推理阶段才求 ODE。
2.7.7 训练推理轨迹
-
这里很容易产生一个误解: 训练时 GT 明明永远是
-
关键在于公式121中的速度是:
-
根据前面公式102,模型真正学到的是所有可能条件速度的后验平均:
-
对于 Rectified Flow:
- 每一对
- 但是很多不同的直线会在空间中混合;
- 同一个位置
- 网络最终学习的是这些条件速度的平均;
- 所以最终得到的 marginal velocity field 通常仍然可能是弯曲的。例如训练的时候你采样的x0=(0,0), x1=(10,0)。此时定义的条件分布转移路径上,中间有十个分布,每个分布得到的xt都是在x轴上,这就是所谓的直线运动。但是到了推理过程,我现在只能采样得到x0=(0,0)。此时我不知道它对应的x1是多少,输入网络,网络得到0.1时刻的速度往右走得到
- 每一对
-
这也正是后面的 Reflow、OT-CFM 等方法想进一步解决的问题:尽量让最终的边缘概率流本身也更加直,从而减少 ODE 推理所需要的步数。
-
既然flowmatching推理的轨迹也是直线,那凭什么说
2.8 Reflow
- 前面分析过,由于训练的时候随机采样x0和x1进行配对,配对后轨迹存在交叉,因此最终推理的概率流并不是直线,而成了折线。怎么让最终的概率流更直呢?
- 可以先做一次训练,得到一个速度场。然后进行生成,采样
- 然后做第二次训练,不再像第一次那样随机把
- 由于这批(
- 路径越直,数值求解 ODE 时就越可以使用更大的时间步长,因此 Reflow 可以进一步减少采样步数,为少步甚至一步生成打基础。
- Reflow 本质上是“为了加速而重整生成路径”的自蒸馏方法,它主要提升少步采样能力,而不是给模型增加新的生成知识。
3. 总结对比
- DDPM:
- 首先定义一个固定的马尔可夫前向扩散过程,不断向数据加入高斯噪声,使数据最终接近标准高斯分布。
- 训练时学习这个扩散过程的反向去噪信息,实际通常让网络预测加入的噪声
- 推理时从高斯噪声开始,根据学习到的反向分布逐步去噪,并且每一步通常还会采样随机噪声,因此是一个随机反向马尔可夫过程;在连续时间极限下可以写成反向 SDE。。
- DDIM:
- 在保持 DDPM 的
- 因为训练时使用的边缘分布和噪声预测目标没有改变,所以可以直接复用 DDPM 训练好的网络,不需要重新训练。
- 推理时通过参数
- 在保持 DDPM 的
- flow matching:
- 并没有像DDPM那样定义前向加噪过程,而是从推理过程的角度(分布转移)出发,分析生成模型需要学习的是一个能将分布进行转换的速度场,利用这个速度场将简单分布一步步转换到数据分布。
- 然后由于直接求这个边缘分布的速度场比较困难,他就引入了容易构造的条件概率路径
- 最后只需要人为定义这个条件分布就行了,比如我可以把这个条件分布定义成高斯分布,然后把他的均值和方差根据条件分布的条件来进行构造,比如常见的把他定义成线性插值的形式。他的速度就是固定的。
- flow matching相比于diffusion的一个好处就是我可以人为定义一条简单的概率流路径。如果选择的路径更直,在采样的时候就更有可能使用更大的步长。
DDPM与flow matching的区别
- DDPM 和 Flow Matching 在连续时间视角下本质上都可以看作:先规定一条概率路径
| 方法 | 概率路径怎么来 | 模型主要学习什么 | 推理动力学 | 是否随机 | 采样特点 |
|---|---|---|---|---|---|
| DDPM | 由前向马尔可夫加噪过程定义 | noise / score | 反向 SDE / 离散反向去噪过程 | 通常随机 | 原始采样步数较多 |
| DDIM | 保持 DDPM 的
|
直接复用 DDPM 的 noise 预测网络 | 重新构造的非马尔可夫生成过程 |
|
|
| Flow Matching | 直接人为设计 probability path / conditional path | velocity field
|
ODE:
|
通常确定性 | 路径设计更自由,更适合少步积分 |
3. Diffusion进阶
3.1 DiT
- DiT(Diffusion Transformer)在 LDM 的框架基础上,将原本用于噪声预测的 U-Net 替换为 Transformer。由于原始DiT仅仅用于class-conditioned任务,条件注入部分只有时间步
- DiT 并没有修改 DDPM 的扩散过程与训练目标,核心研究的是:如何使用 Transformer 对二维 latent 特征进行噪声预测。
3.1.1 整体流程
1)VAE 编码
- 使用预训练的 VAE Encoder 将图像压缩到 latent 空间,随后按照 DDPM 的前向过程对 latent 加噪,得到
2)Patchify
- Transformer 的输入是 token 序列,因此要将二维 latent
- 实际上代码中通常直接用Conv2d一次完成 切 patch + Linear embedding。
3)条件注入
- DiT 有两个条件:
- diffusion timestep
- class label
- diffusion timestep
-
时间步处理:时间【1】正弦编码 -> 【256】再通过mlp到通道维度 -> 【D】
-
假设一共10个类别,定义一个
-
二者相加:

-
普通的LayerNorm:
-
adaLN 先将条件
-
adaLN-Zero进一步在每个 residual branch 上又增加了一个 gate:
- 先将条件
- 第一套给前半部分的attention:
- 第二套给后半部分的MLP:
- 这里在zero是指成这 6 个参数的最后一层 Linear 被初始化为 0。
- 先将条件
4)Unpatchify
- 最后的 token 经过 Linear,将维度映射为:
3.2 Stable Diffusion
| 版本 | 发布时间 | 核心变化 |
|---|---|---|
| SD V1 公共版 | 2022-08-22 | LDM + UNet + CLIP |
| SD V1.5 | 2022-10-20 | V1 系列最流行 checkpoint |
| SD V2.0 | 2022-11-24 | OpenCLIP、768、v-prediction |
| SD V2.1 | 2022-12-07 | V2 最终主要版本 |
| SDXL 1.0 | 2023-07-26 | 大 UNet、双 CLIP、1024 |
| SDXL Turbo | 2023-11-28 | ADD,1~4 step |
| SD3 Early Preview | 2024-02-22 | MMDiT + Rectified Flow |
| SD3 Medium 开放权重 | 2024-06-12 | 2B MMDiT |
| SD3.5 Large / Large Turbo | 2024-10-22 | SD3.5 |
| SD3.5 Medium | 2024-10-29 | 2.5B |
3.2.1 SD V1
- SD V1.5是v1v2版本中使用最广泛、开源社区最齐全的版本。其生成的图片的分辨率为512。
1)网络架构
- 标准的LDM架构:
- VAE:输入512,下采样倍率为8
- CLIP ViT-L/14:文本 prompt 编码成 token feature:
- Unet:包含 ResBlock、Self-Attention 和 Cross-Attention
- Unet结构(SD1.5)
| 部分 | 分辨率 | 通道数 | 主要结构 |
|---|---|---|---|
| 输入 | 64\times64 | 4 → 320 | Conv |
| Down 1 | 64\times64 | 320 | 2×[ResBlock + Transformer] + Downsample |
| Down 2 | 32\times32 | 640 | 2×[ResBlock + Transformer] + Downsample |
| Down 3 | 16\times16 | 1280 | 2×[ResBlock + Transformer] + Downsample |
| Down 4 | 8\times8 | 1280 | 2×ResBlock |
| Middle | 8\times8 | 1280 | ResBlock → Transformer → ResBlock |
| Up 1 | 8\times8 | 1280 | 3×ResBlock + Upsample |
| Up 2 | 16\times16 | 1280 | 3×[ResBlock + Transformer] + Upsample |
| Up 3 | 32\times32 | 640 | 3×[ResBlock + Transformer] + Upsample |
| Up 4 | 64\times64 | 320 | 3×[ResBlock + Transformer] |
| 输出 | 64\times64 | 320 → 4 | GroupNorm + SiLU + Conv |
- 其中这里的 Transformer 内部就是:SA+CA+FFN
- Down 和 Up 对应层之间还有 skip connection。
2)参数量
| 模块 | 参数量 | FP32 大致存储 |
|---|---|---|
| UNet |
|
|
| CLIP ViT-L/14 |
|
|
| VAE |
|
|
| 总计 | 约 1.07B | — |
3)训练策略
- 文本条件:从 SD v1.3 开始,使用了 10% text-conditioning dropout,从而同时学到 conditional 和 unconditional prediction,为 Classifier-Free Guidance 提供基础。
- 版本关系大致是:
- v1.1:
- 237k steps,256×256,LAION-2B-en
- 再 194k steps,512×512,LAION-high-resolution,约 170M 图像。
- v1.2:
- 从 v1.1 继续训练
- 515k steps,512×512,LAION improved-aesthetics。
- v1.5:
- 从 v1.2 初始化
- 595k steps,512×512,LAION-Aesthetics v2 5+
- v1.1:
- 两阶段训练:
- 256 分辨率上的 laion2B-en 数据集,约 237,000 步
- 512 的 high-resolution 数据上(170M 对)进行微调。总体训练使用 LAION-5B 的子集,上游筛选为 “LAION-Aesthetics v2 5+” 等更加高质量图像。
3.2.2 SD V2
- v1 的小改进版本,一方面替换了更先进的文本编码器,此外,增加了对于NSFW内容的限制(这也可能是为什么没有v1.5版本受欢迎的原因)。有 512 和 768 两个版本。这一版本的768分辨率开始使用 v-prediction。
- SD V2.1 是 V2 系列中最终的主要版本。
1)网络架构
- 网络架构与v1基本一致,仅将文本编码器替换为OpenCLIP-ViT-H/14(token维度1024),并基于此修改了UNet中Cross-Attention的相关矩阵维度,其余未修改。
2)参数量
| 模块 | SD1.5 | SD2.x | 主要变化 |
|---|---|---|---|
| UNet |
|
|
Cross-Attention condition 768 → 1024 |
| Text Encoder |
|
|
CLIP ViT-L → OpenCLIP ViT-H |
| VAE |
|
|
基本不变 |
| 总计 |
|
约 1.29B | 主要增长来自 Text Encoder |
- unet参数量的增加主要是CA里面的tok和tov矩阵输入维度768 → 1024
3)训练策略
- 训练数据升级(2.0)
- LAION-5B 的筛选子集
- 先在
SD2 / SD2.1 768使用v-prediction ,不再直接预测噪声- 为什么要做这么个v-prediction,他的好处是啥?
-
- v-prediction定义:
- 此外,
-
3.2.3 SD XL
- SD XL是继 v1.5后更受欢迎的版本,其对于提示词的理解能力要强于v1v2版本,前两版本一般需要使用短语提示词并附加许多其他提示词(如high quality、8k、masterpiece等质量提示词)才能生成较好的图像,而SDXL可以理解短语也可以理解自然句子,对于质量提示词的需求降低。SDXL 能够生成1024的图像。
1)网络架构

- 仍然是LDM架构:
- VAE(重新训练微调,性能更优):输入1024,下采样倍率为8
- 双文本编码器:CLIP ViT-L 和 OpenCLIP ViT-bigG,分别为768, 1280维度。两者 token embedding 在 channel 维拼接成2048
- 两个Unet:第一个base(功能与v1v2一样做文生图),第二个Refiner(用于精细出图,图生图)
- Base模型相比于v1v2模型增加了更多的Transformer模块,OpenCLIP ViT-G输出的文本向量还投影到time embeding大小并加到time embedding上。
- Base Unet对比:
| 部分 | SD1.5 / SD2 | SDXL |
|---|---|---|
| UNet尺度 | 4级 | 3级 |
| Channel multiplier | [1,2,4,4] | [1,2,4] |
| Transformer blocks | [1,1,1,1] | [0,2,10] |
| Cross-Attention context | 768 / 1024 | 2048 |
- Refiner是可选的,专门处理低噪声阶段的最后一部分去噪,用于增强纹理、人物脸部和背景细节。论文中 Refiner 专门训练在前 200 个低噪声 noise scales 上。他有四个尺度,只使用 OpenCLIP bigG,其结构如下:
| 部分 | 分辨率 | 通道数 | 主要结构 |
|---|---|---|---|
| 输入 | 128\times128 | 4 → 384 | Conv |
| Down 1 | 128\times128 | 384 | 2×ResBlock + Downsample |
| Down 2 | 64\times64 | 768 | 2×[ResBlock + Transformer] + Downsample |
| Down 3 | 32\times32 | 1536 | 2×[ResBlock + Transformer] + Downsample |
| Down 4 | 16\times16 | 1536 | 2×ResBlock |
| Middle | 16\times16 | 1536 | ResBlock + Transformer + ResBlock |
| Up | 对称恢复 | 1536→768→384 | ResBlock / Transformer + Upsample |
2)参数量
| 模块 | 参数量 | 存储大小 | 主要变化 |
|---|---|---|---|
| Base UNet | 2.6B | 10.3GB | Transformer blocks 大幅增加 |
| Refiner | 2.3B | 9.04GB | |
| VAE | 约 84M | 335MB | 与前代规模接近 |
| CLIP ViT-L | 123M | 492MB | |
| OpenCLIP ViT-G | 694M | 2.78GB |
3)训练策略
- Micro-Conditioning:加入图像尺寸信息
- 以前 SD1/2 往往直接丢弃分辨率太低的训练图像,或者强行放大,会导致数据损失或模糊。SDXL把图片尺寸
- 以前 SD1/2 往往直接丢弃分辨率太低的训练图像,或者强行放大,会导致数据损失或模糊。SDXL把图片尺寸
- Crop Conditioning
- 以前训练时 random crop 可能导致模型学到“人物头被裁掉”等错误构图。SDXL额外把 crop 坐标:
- 以前训练时 random crop 可能导致模型学到“人物头被裁掉”等错误构图。SDXL额外把 crop 坐标:
- 多宽高比训练
- SDXL 在后期训练中不再只固定 1024,而是使用多个 aspect-ratio bucket。只要像素总量接近
- SDXL 在后期训练中不再只固定 1024,而是使用多个 aspect-ratio bucket。只要像素总量接近
- Noise Offset
- 在训练时,不只加入标准的逐像素高斯噪声,还额外加入一个较低频、通常在空间维度上共享的随机偏置噪声。这样可以改变整张图像/latent 的整体均值,使模型更容易学习非常亮或非常暗的样本,从而改善纯黑、纯白、高对比度场景的生成能力。
- 多阶段训练
- 先使用256的图像进行 600 k 步训练;
- 使用512图像进行 200 k 步训练;
- 最终在1024的上进行多尺度训练,并使用noise offset技巧。
3.2.4 SDXL Trubo
- SDXL Turbo 基于 SDXL Base,网络主体没有发生本质变化,核心改进在训练方法。它使用 Adversarial Diffusion Distillation(ADD),把原本需要几十步采样的 SDXL 蒸馏成 1~4 步生成。(在蒸馏过程中,cfg训练策略是被丢弃的)。其使用两个损失:1)对抗损失;2)以SDXL原模型为教师模型的蒸馏损失。
- 首先从数据集中随机采样一张干净图片
- 得到 Student 生成的
- 第二个是 Score Distillation Loss。这里不是简单让 Student 的输出和
- 最后一个蒸馏损失这里为什么要拿teacher预测的x0做监督?用刚刚采样的真实x0做监督不好吗?在 SDXL Turbo 中,训练时虽然知道
- 最后一个蒸馏损失这里为什么要拿teacher预测的x0做监督?用刚刚采样的真实x0做监督不好吗?在 SDXL Turbo 中,训练时虽然知道
3.2.5 SD V3
- SD 3 不再使用DDPM作为基础扩散模型,而是使用 Rectified Flow,同时主网络换成DiT。
1)网络架构
- 不再使用 LDM 模型,而是使用 Multimodal Diffusion Transformer (MMDiT),
- VAE:通道数从4提升到16,下采样倍率仍为8,能够更好的处理高分辨率图像
- 文本编码:CLIP ViT-L (token维度为768)、 OpenCLIP ViT-bigG (token维度为1280)和 T5XXL 文本编码器(token维度4096)
- MMDiT
MMDiT

- Text Embedding构造方面,首先分别提取CLIP ViT-L和OpenCLIP ViT-bigG的倒数第二层的特征,拼接在一起得到77x2048维度的CLIP Text Embeddings;再从T5-XXL Encoder中提取最后一层的T5 Text Embeddings特征,维度大小是77x4096(这里也限制token长度为77)。紧接着对CLIP Text Embeddings使用zero-padding得到和T5 Text Embeddings相同维度的编码特征。最后,将padding后的CLIP Text Embeddings和T5 Text Embeddings在token维度上拼接在一起,得到154x4096维度的混合Text Embeddings。(在使用时,可以不使用 T5XXL,T5XXL对应特征值直接取 0 即可,图像生成能力不会下降太多,但是文字渲染和文字理解能力会有明显损失)。
- 在之前的Stable Diffusion中,Text Embedding是通过 CrossAttention机制引入的,而在MM-DiT中,Text Embedding则是与图像patch embedding 拼接(concat)到一起进行处理,将文本特征与图像特征放到同一等级重要性。原DiT中的 AdaLN技术则是主要用于引入 timestep(也引入了pooled text embedding 全局语义信息)。
- 实际上可以视为在一个 MMDiT block中包含了两个transformer 块,分别用于处理文字特征与图像特征,而仅仅是在中间的Attention模块,将两个特征合并处理,以起到文字与图像特征交互的作用。
MMDiT-X

- 在MMDiT 模块的基础上,在整个Transformer的前13层引入了子注意力模块,以此增强多分辨率生成能力和整体图像连贯性。
2)参数量
| 模块 | 参数量 | FP16 大小约 |
|---|---|---|
| SD3.5 Medium MMDiT | 2.5B | 4.94 GB |
| SD3.5 Large MMDiT | 8.1B | 16.3 GB |
| SD3.5 Large Turbo MMDiT | 8.1B | 16.3 GB |
| CLIP ViT-L | 123M | 247 MB |
| OpenCLIP ViT-bigG | 694M | 1.39 GB |
| T5-XXL Encoder | 4.76B | 约 9.5~9.8 GB |
3)训练策略
- 与前面版本相似的是,仍使用NSFW检测模型过滤这些数据,删除美学评分低和重复的数据。
- 使用多模态模型CogVLM生成高质量的精细化caption标签,获得包含描述图像主题的短Caption标签以及详细描述图像内容的长Caption标签;
- 三个text encoder标签各自以 46.4%比例单独dropout ,文本完全dropout的比例为
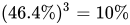 ,以实现Classifier-free Guidance(应该也是因此可以在不使用 T5XXL时保持一定图像生成性能。)。
- 对QK矩阵进行 RMS Norm,即均值为0的Layer Norm,避免QK矩阵不稳定的问题。
- 设计了多尺度位置编码,将宽高映射到最大尺寸进行编码。
- 在训练时,对于高分辨率图像与低分辨率图像采用不同的偏移比率,将高分辨率与低分辨率的比例进行漂移,保证加噪效果相同。